Local primero
Las funciones principales pueden ejecutarse en hardware que controlas en casa o dentro de una organización.
La misma persona puede aparecer en PC, smartphone, pantalla, avatar y cabeza robótica física. Voz, contexto, recuerdos y comportamiento forman un único entorno local coherente.
Las funciones principales pueden ejecutarse en hardware que controlas en casa o dentro de una organización.
MELAVRA se diseña alrededor del propietario, su idioma, rutinas, roles y preferencias.
La inteligencia puede estar presente mediante voz, avatar, cabeza robótica y futuros dispositivos físicos.
El núcleo de IA no está ligado a una sola pantalla. MELAVRA conecta varios dispositivos y formas de expresión con una misma persona.
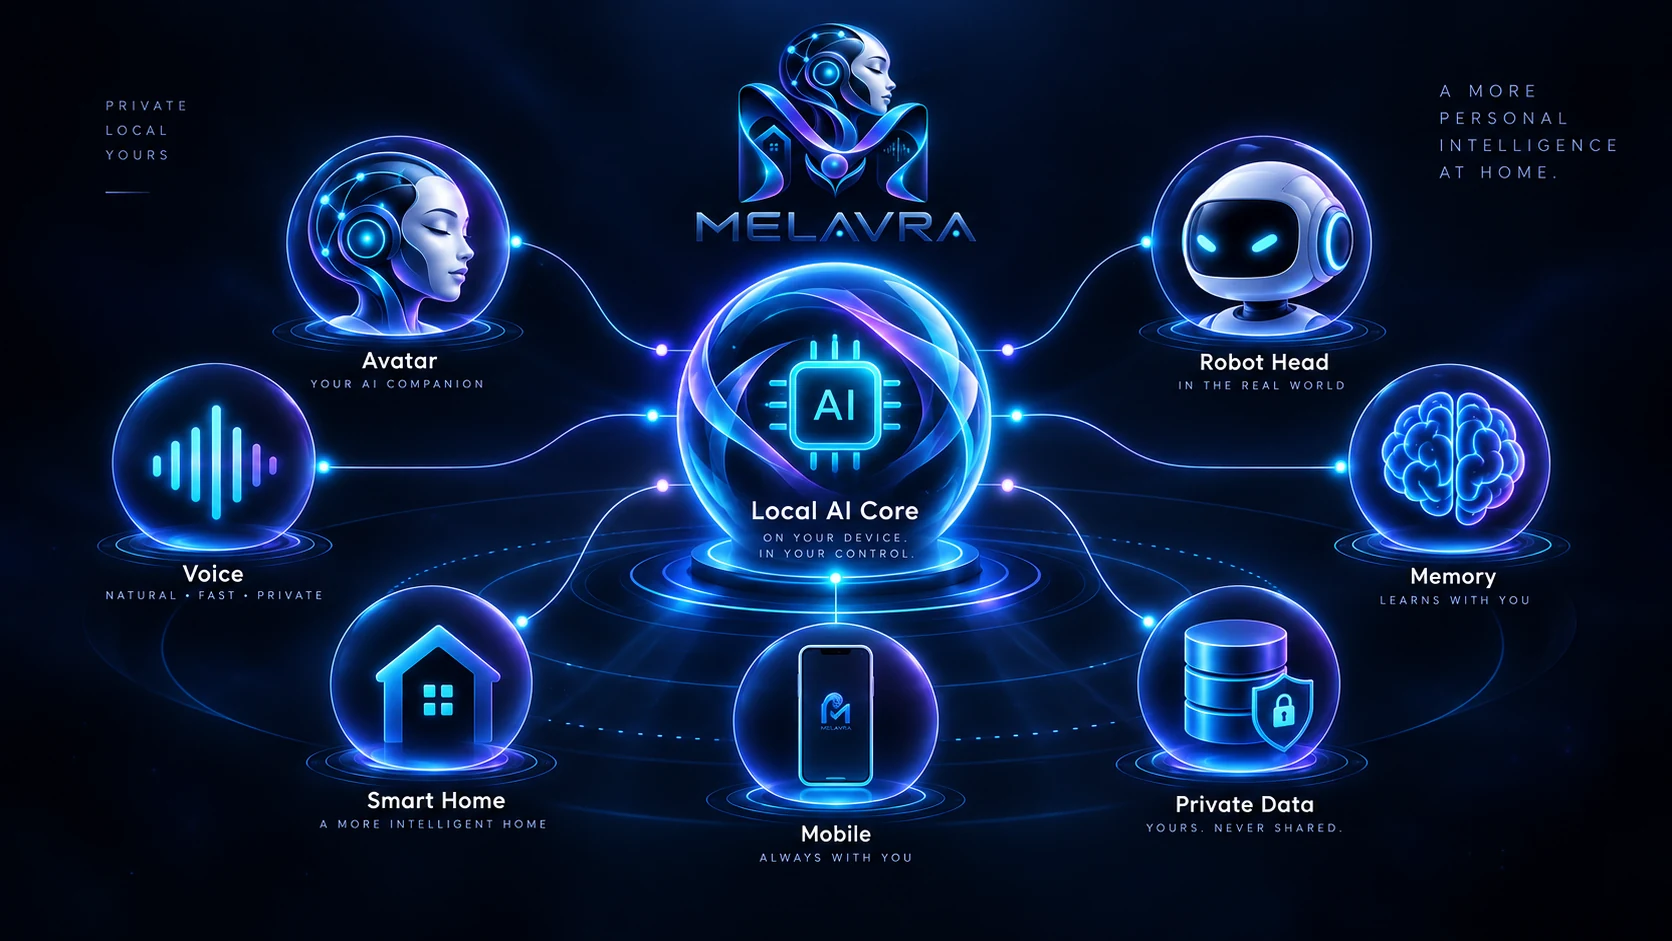
Las etiquetas de estado separan lo que funciona hoy, lo que está en prototipo y lo que sigue en desarrollo.
Modelos locales y runtime en hardware que controlas.
Reconocimiento de voz local, diálogo y síntesis de voz.
Expresión facial, mirada, parpadeo, microexpresión y estados de comportamiento.
Presencia física con ojos, párpados, boca, movimiento de cabeza y audio.
Contexto a largo plazo, preferencias e historial personal de trabajo.
Cliente LAN para diálogo, streaming de avatar y comunicación local.
Una sola persona como capa natural de control y contexto del hogar.
Cámaras y sensores como contexto local adicional.
Los modelos locales, la voz, la persona y los servicios de apoyo pueden ejecutarse en tu propio hardware. Los servicios online son extensiones opcionales, no un requisito.
El objetivo es no exigir que conversaciones privadas y recuerdos personales se envíen a servicios cloud externos. El procesamiento local es la base; los servicios externos se añaden solo cuando aportan un beneficio claro.
MELAVRA también cubre preparación de datos de voz y entrenamiento, evaluación, pruebas de modelos y futura adaptación a tareas concretas.
MELAVRA se desarrolla como un sistema continuo de I+D. Por eso se muestran por separado las capacidades actuales y los objetivos futuros.
Micrófono → reconocimiento local → LLM local → síntesis local → reproducción en el dispositivo objetivo.
Expresión, movimiento y salida audiovisual se combinan en una presencia física.
Contexto continuo, preferencias del propietario, roles, reglas y conocimiento recuperable.
Futuro reconocimiento del propietario, hablantes autorizados y respuestas sensibles al contexto.
Control de dispositivos, sensores, horarios y servicios locales mediante la misma persona.
La forma larga en inglés sigue siendo parte de la marca. Cada componente se explica en el idioma seleccionado.
Escríbenos si te interesa MELAVRA, la colaboración, la integración o el desarrollo.