Local primeiro
As funções principais podem funcionar em hardware que controla em casa ou numa organização.
A mesma persona pode aparecer num PC, smartphone, ecrã, avatar e cabeça robótica física. Voz, contexto, memórias e comportamento permanecem partes de um único ambiente local coerente.
As funções principais podem funcionar em hardware que controla em casa ou numa organização.
MELAVRA é concebida em torno do proprietário, da sua língua, rotinas, funções e preferências.
A inteligência pode estar presente através da voz, avatar, cabeça robótica e futuros dispositivos físicos.
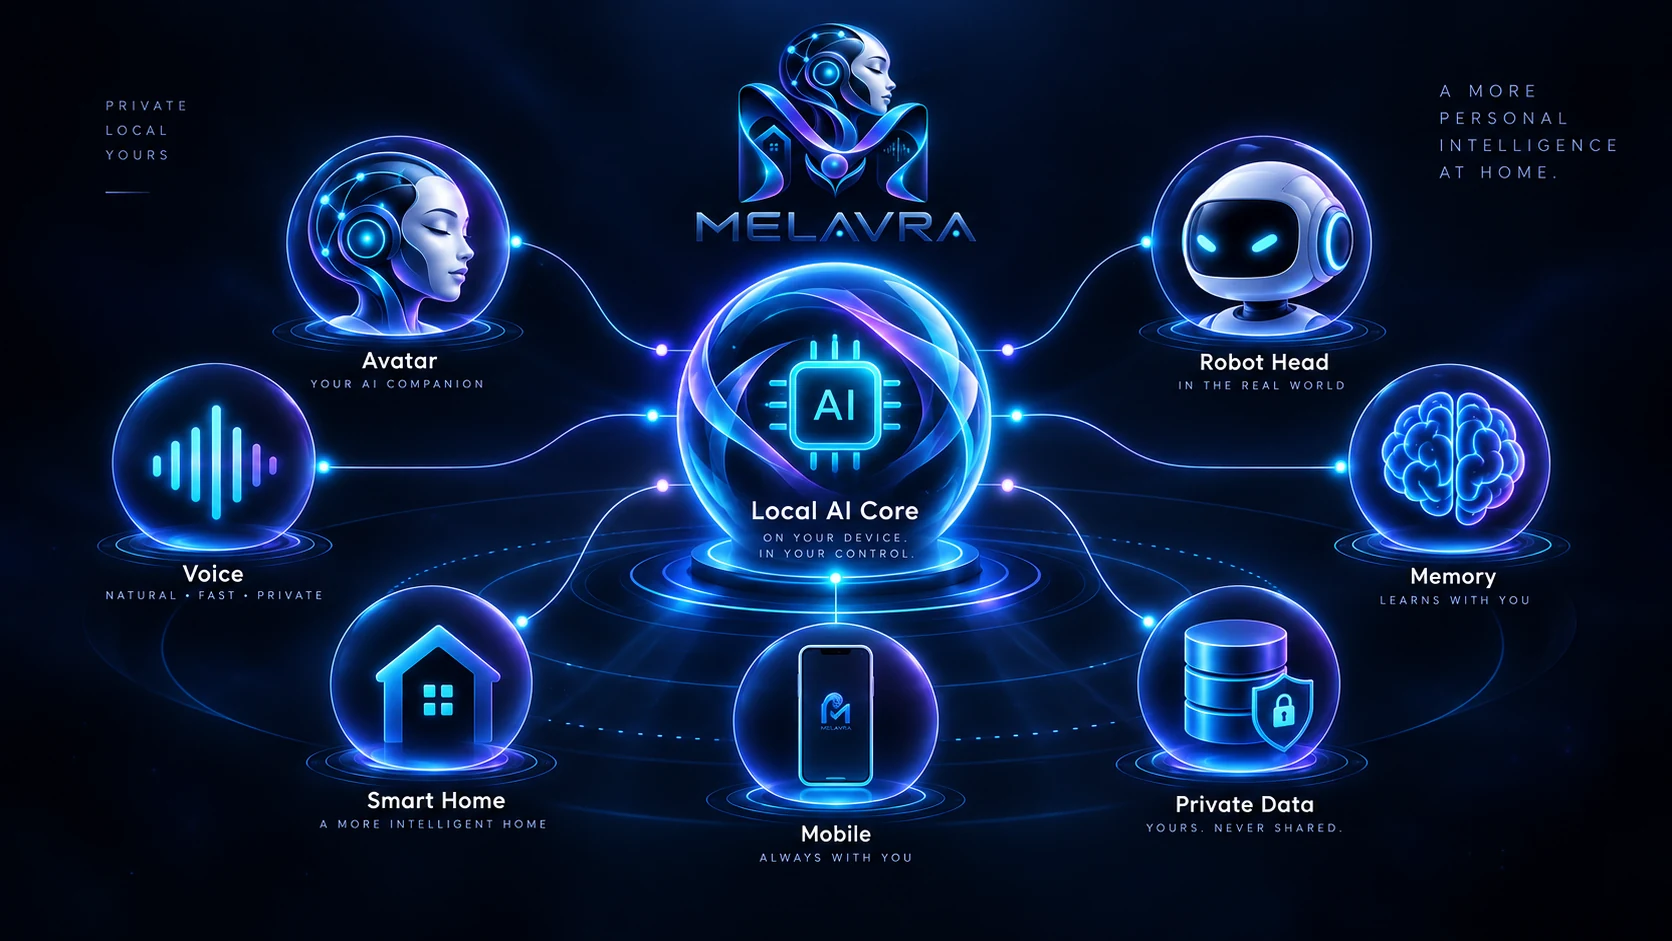
O núcleo de IA não está preso a um único ecrã. MELAVRA liga vários dispositivos e formas de expressão a uma só persona.
Os estados distinguem deliberadamente o que funciona hoje, o que existe como protótipo e o que ainda está em desenvolvimento.
Modelos locais e runtime em hardware que controla.
Reconhecimento de voz local, diálogo e síntese de voz.
Expressão facial, olhar, piscar, microexpressões e estados de comportamento.
Presença física com olhos, pálpebras, boca, movimento da cabeça e áudio.
Contexto de longo prazo, preferências e histórico pessoal de trabalho.
Cliente LAN para diálogo, streaming do avatar e comunicação local.
Uma só persona como camada natural de controlo e contexto da casa.
Câmaras e sensores como contexto local adicional.
Modelos locais, voz, persona e serviços de apoio podem funcionar no seu próprio hardware. Os serviços online continuam a ser extensões opcionais.
O objetivo é não exigir o envio de conversas privadas e memórias pessoais para serviços cloud externos. O processamento local é a base; serviços externos são adicionados apenas quando oferecem um benefício claro.
MELAVRA também cobre workflows para dados de voz e treino, avaliação, testes de modelos e futura adaptação a tarefas concretas.
MELAVRA é desenvolvida como um sistema contínuo de I&D. As capacidades atuais e os objetivos futuros são por isso apresentados separadamente.
Microfone → reconhecimento local → LLM local → síntese local → reprodução no dispositivo alvo.
Expressão, movimento e saída audiovisual são combinados numa presença física.
Contexto contínuo, preferências do proprietário, papéis, regras e traços de conhecimento recuperáveis.
Futuro reconhecimento do proprietário, falantes autorizados e respostas sensíveis ao contexto.
Controlar dispositivos, sensores, horários e serviços locais através da mesma persona.
A forma longa em inglês permanece parte da marca. Cada componente é explicado na língua selecionada.
Contacte-nos se estiver interessado em MELAVRA, colaboração, integração ou desenvolvimento.