
Сначала локально
Ключевые функции могут работать на собственном оборудовании дома или внутри организации.
MELAVRA объединяет локальное ядро ИИ, голос, долговременную память, цифровой аватар, Robot Head и умный дом — под контролем владельца.
Одна Persona может появляться на компьютере, смартфоне, дисплее, в цифровом аватаре и физической Robot Head. Голос, контекст, память и поведение остаются частями одной локальной среды.
Ключевые функции могут работать на собственном оборудовании дома или внутри организации.
MELAVRA строится вокруг владельца, его языка, привычек, ролей и предпочтений.
Интеллект может проявляться через голос, аватар, Robot Head и в будущем другие физические устройства.
ИИ не привязан к одному экрану. MELAVRA проектируется как платформа, которая связывает разные устройства и формы присутствия одной Persona.
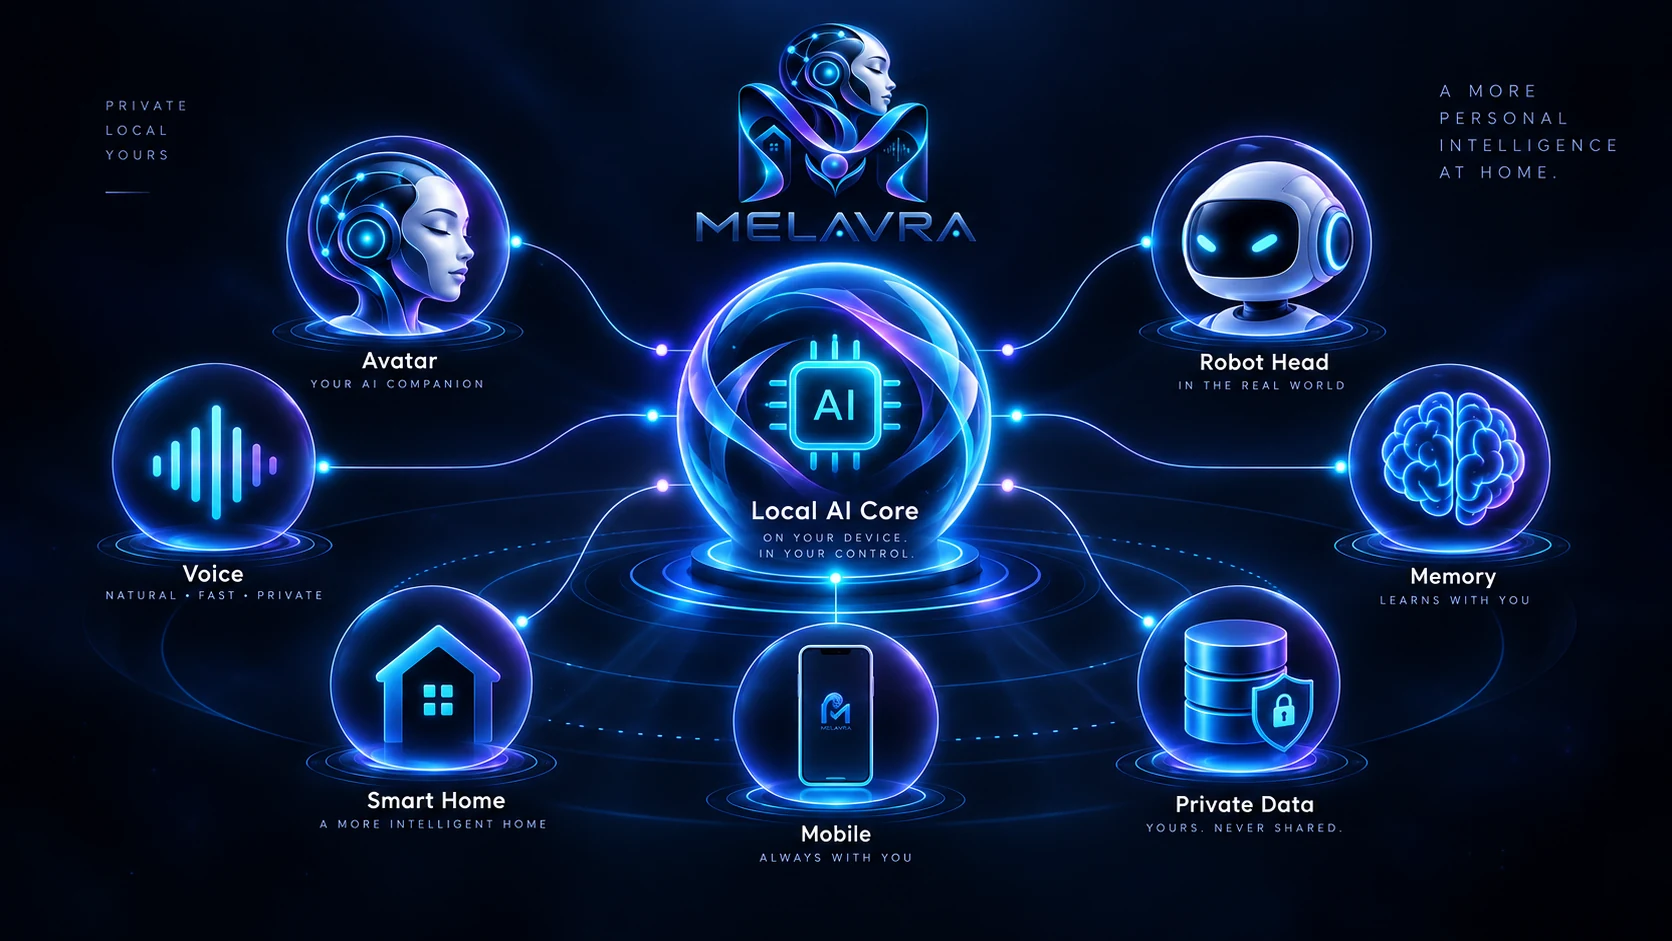
Статусы специально разделяют то, что уже работает, то, что существует как прототип, и то, что ещё находится в разработке.
Локальные модели и runtime на собственном оборудовании.
Локальное распознавание речи, диалог и синтез голоса.
Мимика, взгляд, моргание, микроэмоции и поведенческие состояния.
Физическое присутствие: глаза, веки, рот, движения головы и звук.
Долговременный контекст, предпочтения и история взаимодействия.
LAN-клиент для диалога, стриминга аватара и локальной связи.
Одна Persona как естественный слой управления и контекста для дома.
Камеры и сенсоры как дополнительный локальный контекст.
Локальные языковые модели, голос, Persona и вспомогательные сервисы могут работать на собственном оборудовании. Интернет-сервисы остаются дополнительным инструментом, а не обязательной основой.
Цель системы — не заставлять пользователя отправлять личные разговоры и память во внешнее облако. Локальная обработка является базой, а внешние сервисы подключаются только тогда, когда от них есть понятная польза.
MELAVRA включает процессы подготовки речевых и обучающих датасетов, оценки, тестирования моделей и будущей адаптации под конкретные задачи.
MELAVRA развивается как постоянная R&D-система. Поэтому текущие функции и будущие цели показываются отдельно.
Микрофон → локальное распознавание → локальная LLM → локальный TTS → воспроизведение на целевом устройстве.
Мимика, движение и аудиовизуальный вывод объединяются в физическое присутствие.
Непрерывный контекст, предпочтения хозяина, роли, правила и доступные для поиска знания.
Будущее распознавание владельца, разрешённых голосов и контекстные реакции.
Управление устройствами, сенсорами, расписаниями и локальными сервисами через одну Persona.
Английская полная форма остаётся частью бренда. Значение каждого компонента объясняется на выбранном языке.
Сообщения сохраняются непосредственно на этом сервере и доступны в панели администратора.