Local d’abord
Les fonctions essentielles peuvent fonctionner sur du matériel que vous contrôlez chez vous ou dans une organisation.
La même persona peut apparaître sur un PC, un smartphone, un écran, un avatar et une tête robotique physique. La voix, le contexte, les souvenirs et le comportement restent les parties d’un même environnement local cohérent.
Les fonctions essentielles peuvent fonctionner sur du matériel que vous contrôlez chez vous ou dans une organisation.
MELAVRA est conçue autour du propriétaire, de sa langue, de ses habitudes, de ses rôles et de ses préférences.
L’intelligence peut être présente par la voix, l’avatar, la tête robotique et de futurs appareils physiques.
Le cœur IA n’est pas lié à un seul écran. MELAVRA est conçue comme une plateforme reliant plusieurs appareils et formes d’expression à une même persona.
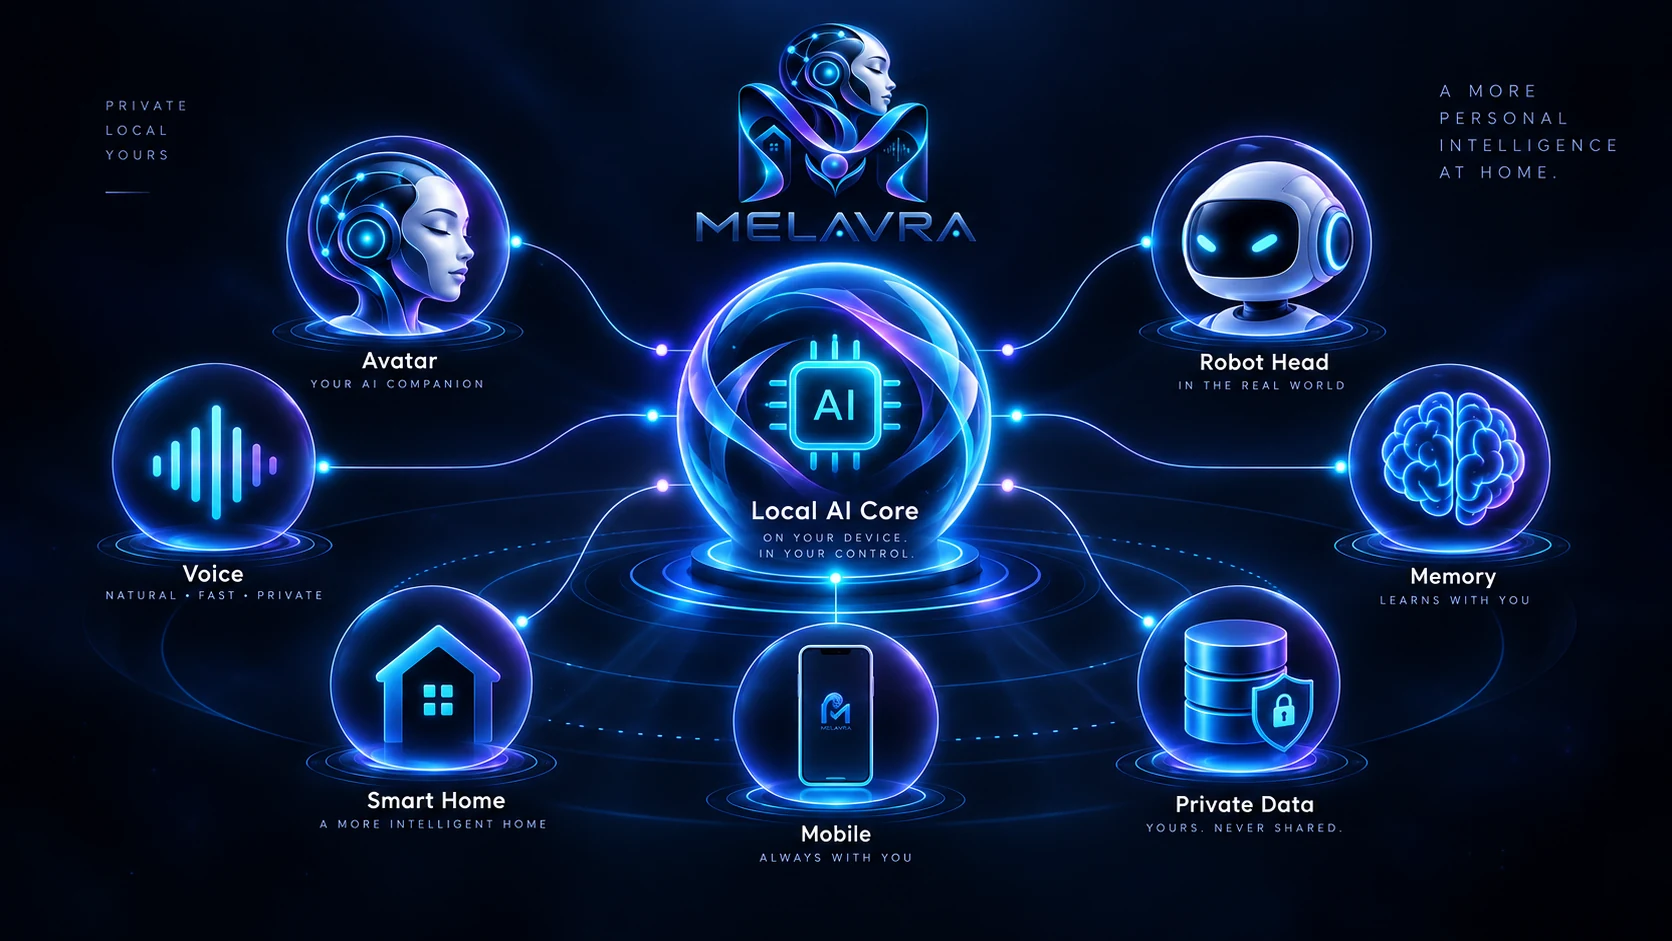
Les statuts distinguent volontairement ce qui fonctionne aujourd’hui, ce qui existe en prototype et ce qui est encore en développement.
Modèles locaux et runtime sur le matériel que vous contrôlez.
Reconnaissance vocale locale, dialogue et synthèse vocale.
Expression faciale, regard, clignements, micro-expressions et états comportementaux.
Présence physique avec yeux, paupières, bouche, mouvements de tête et audio.
Contexte à long terme, préférences et historique personnel de travail.
Client LAN pour le dialogue, le streaming de l’avatar et la communication locale.
Une seule persona comme couche naturelle de contrôle et de contexte pour la maison.
Caméras et capteurs comme contexte local supplémentaire.
Les modèles de langage locaux, la voix, la persona et les services associés peuvent fonctionner sur votre propre matériel. Les services en ligne restent des extensions optionnelles.
L’objectif est d’éviter d’envoyer automatiquement les conversations privées et les souvenirs personnels vers des services cloud externes. Le traitement local est la base; les services externes ne sont ajoutés que lorsqu’ils apportent un bénéfice clair.
MELAVRA couvre aussi les workflows de préparation de données vocales et d’entraînement, d’évaluation, de test des modèles et d’adaptation future à des tâches concrètes.
MELAVRA est développée comme un système R&D continu. Les capacités actuelles et les objectifs futurs sont donc présentés séparément.
Microphone → reconnaissance vocale locale → LLM local → synthèse vocale locale → lecture sur l’appareil cible.
Expression, mouvement et sortie audiovisuelle sont réunis en une présence physique.
Contexte continu, préférences du propriétaire, rôles, règles et traces de connaissances récupérables.
Reconnaissance future du propriétaire, locuteurs autorisés et réponses sensibles au contexte.
Contrôler appareils, capteurs, calendriers et services locaux via la même persona.
La forme longue anglaise reste une partie de la marque. Chaque composant est expliqué dans la langue sélectionnée.
Contactez-nous si vous vous intéressez à MELAVRA, à une collaboration, une intégration ou un développement.